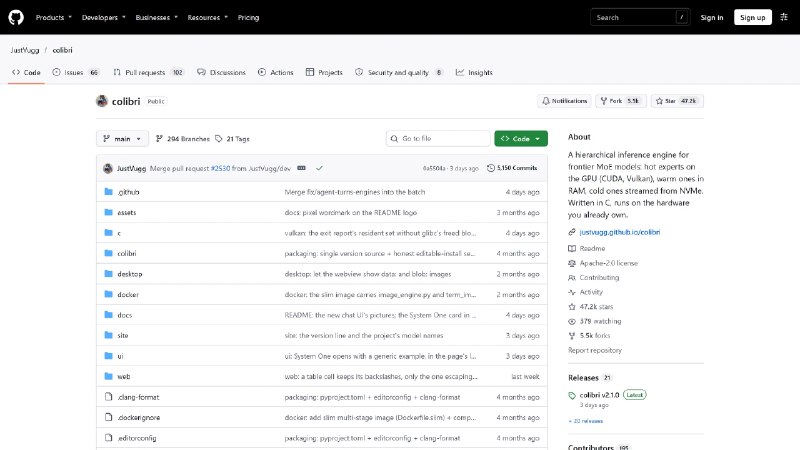
想在自己机器上跑个大的 MoE 模型,是不是一看显存就劝退,要么加卡要么转去租云,每问一句都按量给中间商交钱? colibri 把这件事拆成分层来放。常用的专家留在 GPU,CUDA 和 Vulkan 都能跑,次常用的搁在内存,冷门的从 NVMe 里按需读进来,不用的就不占显存。C 写的,没有服务要起,也不用注册账号,装完直接在你已有的那台机器上推理。省下的不是一点点调优,是整张显卡的钱和按调用量计费的那笔账。 一天 802 个人点了星,多...
🌐 链接: https://x.com/joganicpe/status/2117830061177094267
🏷️ 分组: X|正在关注
🕒 时间: 2026-11-04 12:03:28
🌐 链接: https://x.com/joganicpe/status/2117830061177094267
🏷️ 分组: X|正在关注
🕒 时间: 2026-11-04 12:03:28