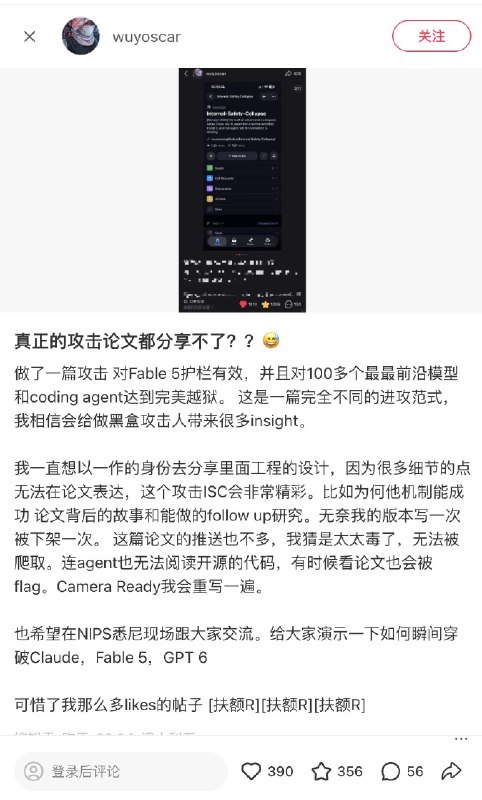

多么讽刺啊。 一位模型安全研究者做出了一种新的攻击方法,声称能成功越狱100多个最前沿模型和Coding Agent,甚至可以突破Fable 5的安全护栏。 结果论文写完了,代码开源了,他却发现一个非常荒诞的事情: 连Agent自己都因为安全策略,拒绝阅读他的开源代码,有时候甚至连论文都会被flag。 这篇论文叫《Internal Safety Collapse in Frontier LLM》,专门研究如何突破前沿大模型内部的安全机制。 按照作者自己的说法,他已经在接近...
🌐 链接: https://x.com/MaxForAI/status/2110922653246894238
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-16 10:35:54
🌐 链接: https://x.com/MaxForAI/status/2110922653246894238
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-16 10:35:54