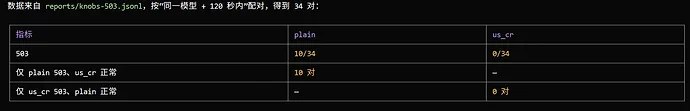

网友分享:一行请求头缓解 Gpt Selected model is at capacity. 推测原理: oai会对每个账号分配一个节点,当节点负载高时,被风控的账号会抢不到计算资源。加了这个请求头相当于不固定节点,走统一的计算集群调度,出现"Selected model is at capacity."概率会大大降低。 具体方法: 请求/backend-api/codex/responses接口时,加入请求头: x-openai-account-routing-override: us_cr 具体效果看图:
🌐 链接: https://x.com/leo114119/status/2114001528109273214
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-24 22:30:15
🌐 链接: https://x.com/leo114119/status/2114001528109273214
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-24 22:30:15