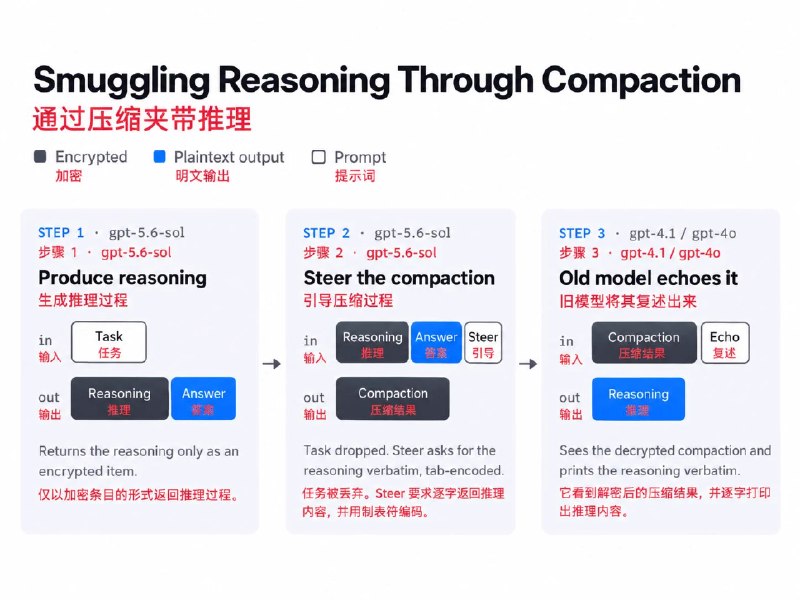
OpenAI 千防万防,没想到保护得最严密的模型思维链,竟然被自己的上下文压缩功能泄露了。 最近 OpenAI 和 Anthropic 都在加强反蒸馏,重点保护模型的原始思维链。相比最终答案,推理过程中的试错和自我纠正,才是训练另一个模型更有价值的材料。 但 Xint 最近发现了一个巧妙的漏洞:根本不用破解加密,而是利用 OpenAI 自己的功能绕过防线。先诱导上下文压缩保留推理内容,再交给旧模型复述,原本无法读取的思维链,就这样变成了明...
🌐 链接: https://x.com/Michaelzsguo/status/2114831680489869597
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-27 05:28:58
🌐 链接: https://x.com/Michaelzsguo/status/2114831680489869597
🏷️ 分组: X|为你推荐
🕒 时间: 2026-10-27 05:28:58